Aventuras con mi homelab: cuando el clúster se convierte en tu segundo trabajo (Parte 1)
Todo empezó con una idea aparentemente sensata: ¿para qué seguir pagando instancias y balanceadores en la nube para proyectos personales si puedo tener mi propia infraestructura en casa?
Así llegaron a mi escritorio Travolta y Thurman, dos mini PCs equipados con procesadores Intel N150, 16 GB de RAM y 256 GB de disco NVMe cada uno. El plan sobre el papel era impecable: desplegar un clúster ligero de K3s mediante Ansible, aprender Kubernetes a fondo sin miedo a una factura imprevista de tres ceros a fin de mes, y tener el patio de recreo perfecto para mis aplicaciones.
Lo que no vi venir fue la rapidez con la que caí en la trampa más clásica del mundillo: el síndrome del homelabber.
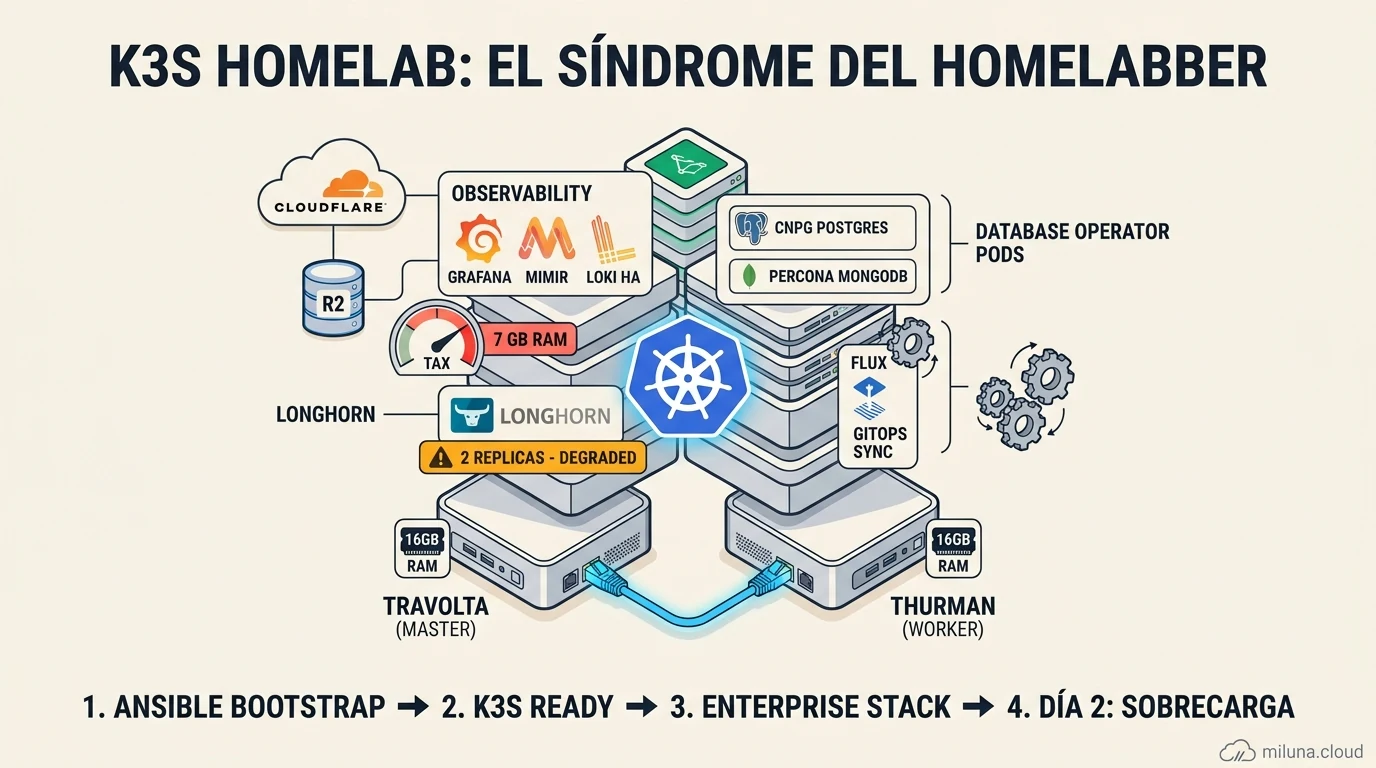
1. La promesa dorada: aprender Kubernetes sin factura cloud
Montar tu propio clúster casero tiene un punto mágico. Desempaquetas las máquinas, configuras tu playbook de Ansible y pulsas Enter. En cuestión de minutos, la automatización dejaba los nodos conectados a una red privada mediante Tailscale, configuraba las claves Ed25519 y resolvía el primer tropiezo clásico de red: desactivar UFW, cuya regla por defecto FORWARD DROP rompía por completo la red overlay de Flannel (VXLAN) y dejaba a los pods sin resolución DNS.
La topología inicial era directa: Travolta actuando como master (dejándolo schedulable para no desperdiciar recursos) y Thurman como worker.
Decidí arrancar con solo dos nodos dejando la puerta abierta a un futuro tercer nodo dedicado a cargas de IA y modelos locales. Claro que, en sistemas distribuidos, una topología de dos nodos es territorio pantanoso: el riesgo de split-brain existe y es real si se produce una partición de red. Pero para un entorno casero parecía un compromiso asumible frente al valor formativo:
- Entiendes las tripas del sistema: En los servicios gestionados de la nube (EKS, GKE), la red, los certificados y el plano de control son cajas negras. Aquí te toca entender cada pieza: CNI (Flannel), balanceo local con MetalLB o Klipper, y gestión de ingress con Traefik.
- Cero estrés financiero: Puedes experimentar con arquitecturas distribuidas, romper nodos y reiniciar cargas de trabajo sin el reloj del proveedor de turno cobrándote por hora de ejecución.
Con el clúster arriba y kubectl get nodes en estado Ready, sentí que tenía un auténtico tesoro entre manos. Y ahí es exactamente donde empezaron los problemas.
2. El mal del Homelabber: meterlo absolutamente todo
La euforia inicial nubla el juicio. Cuando ves que dos chips de bajo consumo mueven pods con soltura, surge esa voz interior que te susurra: “Si ya tenemos Kubernetes, ¿por qué no desplegamos todo como en un unicornio de Silicon Valley?”.
En cuestión de dos semanas, mi inocente clúster albergaba una constelación de herramientas de nivel enterprise:
- GitOps declarativo con Flux CD y SOPS: Todo versionado en Git con secretos cifrados mediante Age/SOPS; nada de aplicar manifiestos a mano.
- El zoo de operadores de datos: No una, sino dos bases de datos en clúster gestionadas por operadores: CloudNativePG (CNPG) para PostgreSQL y el operador de Percona para MongoDB.
- Almacenamiento distribuido con Longhorn: Una pirueta técnica en 2 nodos. Forcé las réplicas a 2 (1 por nodo en vez del estándar de 3) y activé thin provisioning al 200% (
storageOverProvisioningPercentage: 200%) para estirar los 256 GB de los NVMe. - Backups automatizados en Cloudflare R2: Snapshots periódicos cifrados y subidos a almacenamiento S3 compatible.
- Observabilidad nivel Tier-1: Desplegué la suite completa de Grafana: Grafana Alloy como agente unificado recolectando métricas hacia Grafana Mimir (migrado desde Thanos para almacenar métricas a largo plazo en R2) y logs hacia un clúster de Grafana Loki en alta disponibilidad (2 instancias con anillo memberlist) respaldado también en R2.
Sobre el papel, la arquitectura era una obra de arte. En la práctica, había convertido dos mini PCs modestos en un centro de datos hipercomplejo en miniatura.
3. La cruda realidad del Día 2: 7 GB de “peaje” y adiós al foco
El primer choque con la realidad llegó al mirar la telemetría: el sistema operativo base, K3s y el stack de observabilidad (Mimir + Loki HA + Alloy + Grafana) ya devoraban más de 7 GB de RAM antes de haber desplegado una sola línea de código propia. Casi la mitad de la memoria física de Travolta o Thurman se evaporaba simplemente en la fontanería de la plataforma.
Y lo peor no eran los recursos, sino el tiempo operativo. De repente, una tarde cualquiera que planeaba dedicar a programar la lógica de una nueva API se transformaba en:
- El drama del almacenamiento en 2 nodos: Thurman se reiniciaba tras un parche de kernel y Longhorn entraba en pánico. Con un factor de réplica de 2, perder un nodo significaba perder el 50% de la redundancia inmediatamente; el volumen quedaba en estado degradado y Longhorn no tenía un tercer nodo al que migrar datos.
- Depuración de telemetría: Ajustar límites de memoria y depurar por qué los compadictadores de Loki o los pods de Mimir disparaban el consumo al sincronizar bloques contra Cloudflare R2.
- Lidiar con StatefulSets atascados en
Terminatingal intentar actualizar la versión de K3s. - Reconciliaciones rotas: Desbloquear pipelines de Flux bloqueados por conflictos en CRDs de los operadores de Percona o CNPG.
La gestión operativa de las cargas con estado me obligó a hacerme la pregunta incómoda: ¿realmente tiene sentido gestionar StatefulSets, almacenamiento replicado por red y bases de datos en Kubernetes para proyectos personales?
Mi objetivo original era tener una plataforma para desarrollar y probar aplicaciones. Sin embargo, me encontré dedicando las tardes después de mi jornada laboral de 9 a 5 a hacer tareas de soporte, parches y apagado de fuegos no remuneradas. Había creado un segundo trabajo en casa.
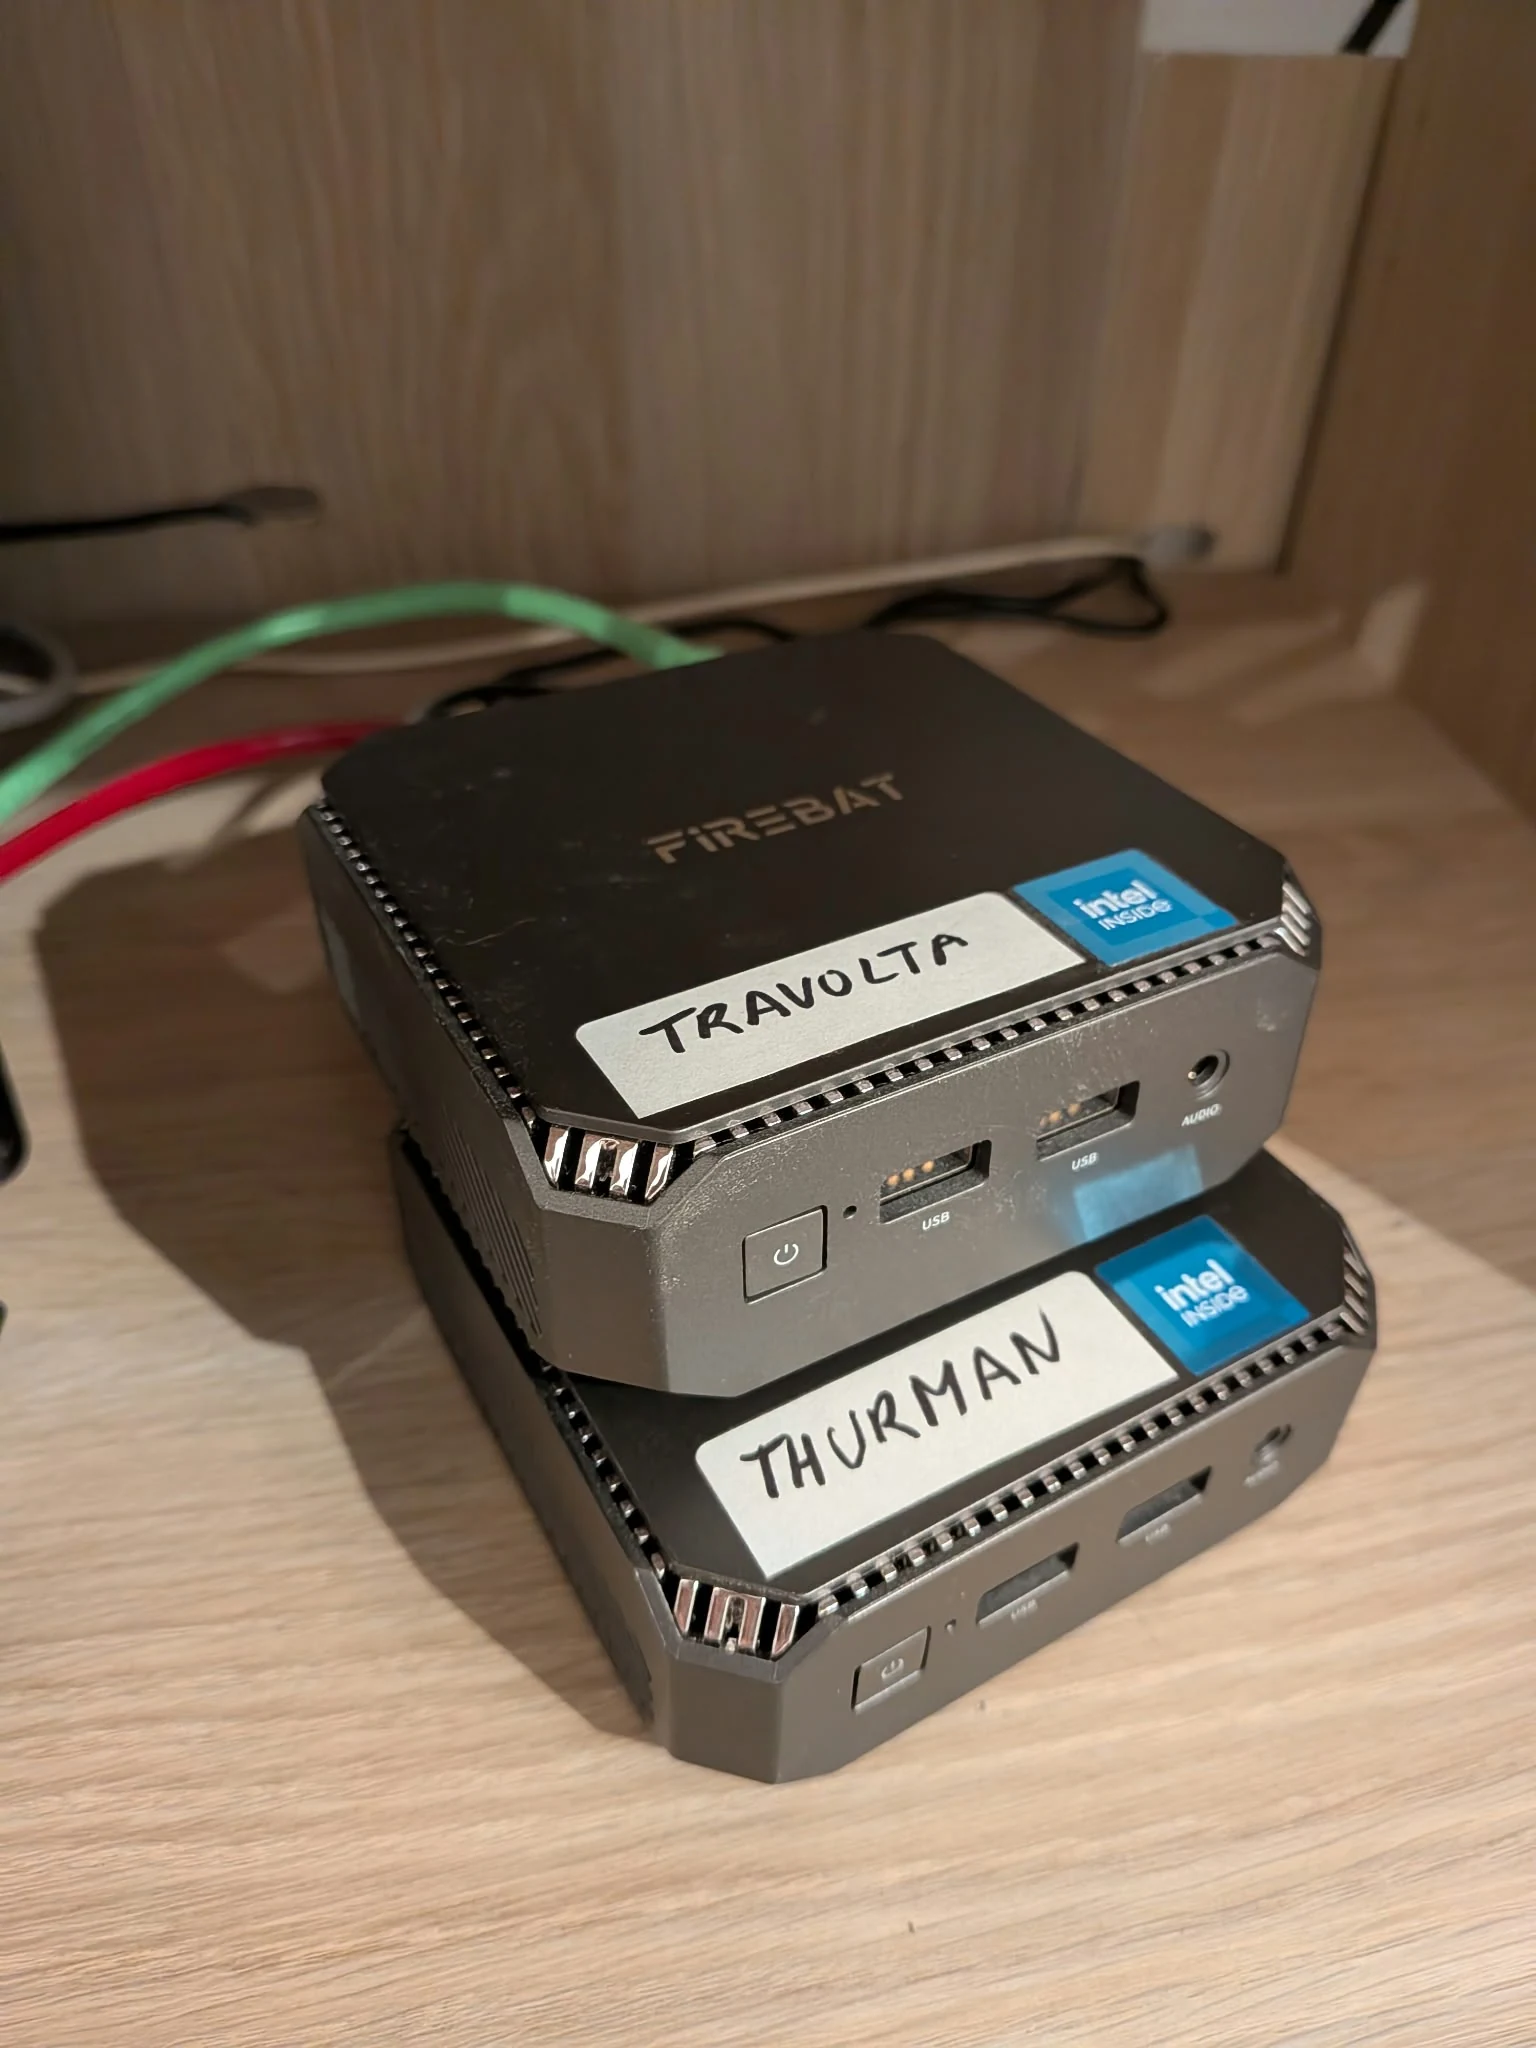 Travolta y Thurman en su hábitat natural: dos mini PCs Firebat inocentes sobre el escritorio, soportando estoicamente todo el peso de la infraestructura.
4. ¿Hacia dónde vamos? (Próximos pasos)
El homelab no ha sido un error; de hecho, ha sido una de las mejores escuelas técnicas de los últimos meses. Pero necesita un baño urgente de pragmatismo. La infraestructura debe estar al servicio del software que crea valor, no al revés.
En la Parte 2 de este artículo te contaré cómo pienso rediseñar y simplificar radicalmente el mantenimiento de Travolta y Thurman:
- Cómo recortar drásticamente ese peaje de 7 GB de observabilidad desmontando piezas sobredimensionadas.
- Por qué sacar la gestión de bases de datos y almacenamiento con estado fuera del clúster puede salvar tu tiempo libre.
- Qué estrategias de automatización aplicar para que el clúster vuelva a ser un trampolín de desarrollo y no una carga operativa tras la jornada laboral.