Por qué abandoné Flux: el caso de GitHub Actions y Tailscale para despliegues ligeros
Durante años, la industria nos ha repetido el mismo mantra dogmático: el verdadero GitOps debe ser exclusivamente Pull. Si no tienes un operador residente dentro de tu clúster reconciliando el estado contra Git cada tres minutos, estás desplegando “a la antigua”.
Cuando monté mi homelab de alta disponibilidad con dos mini PCs (como conté en la primera parte de esta serie), abracé la ortodoxia completa: instalé Flux CD, cifré todos los secretos con Mozilla SOPS y claves Age, y configuré múltiples Kustomization y HelmRelease para cada servicio.
Sobre el papel, la promesa era idílica: inmutabilidad, auditoría absoluta y cero credenciales de producción saliendo del clúster.
En la práctica, me encontré ante una pesadilla operativa desproporcionada. Cada domingo por la tarde terminaba depurando bucles de reconciliación rotos porque un operador se había quedado sin memoria, o descifrando errores crípticos de sincronización de secretos en el clúster.
Este artículo explica por qué decidí matar a Flux en mi infraestructura, cómo rediseñé el despliegue hacia un modelo Push determinista con GitHub Actions y Tailscale, y por qué para infraestructuras pequeñas o medianas, el dogma del GitOps Pull suele ser una trampa de complejidad accidental.
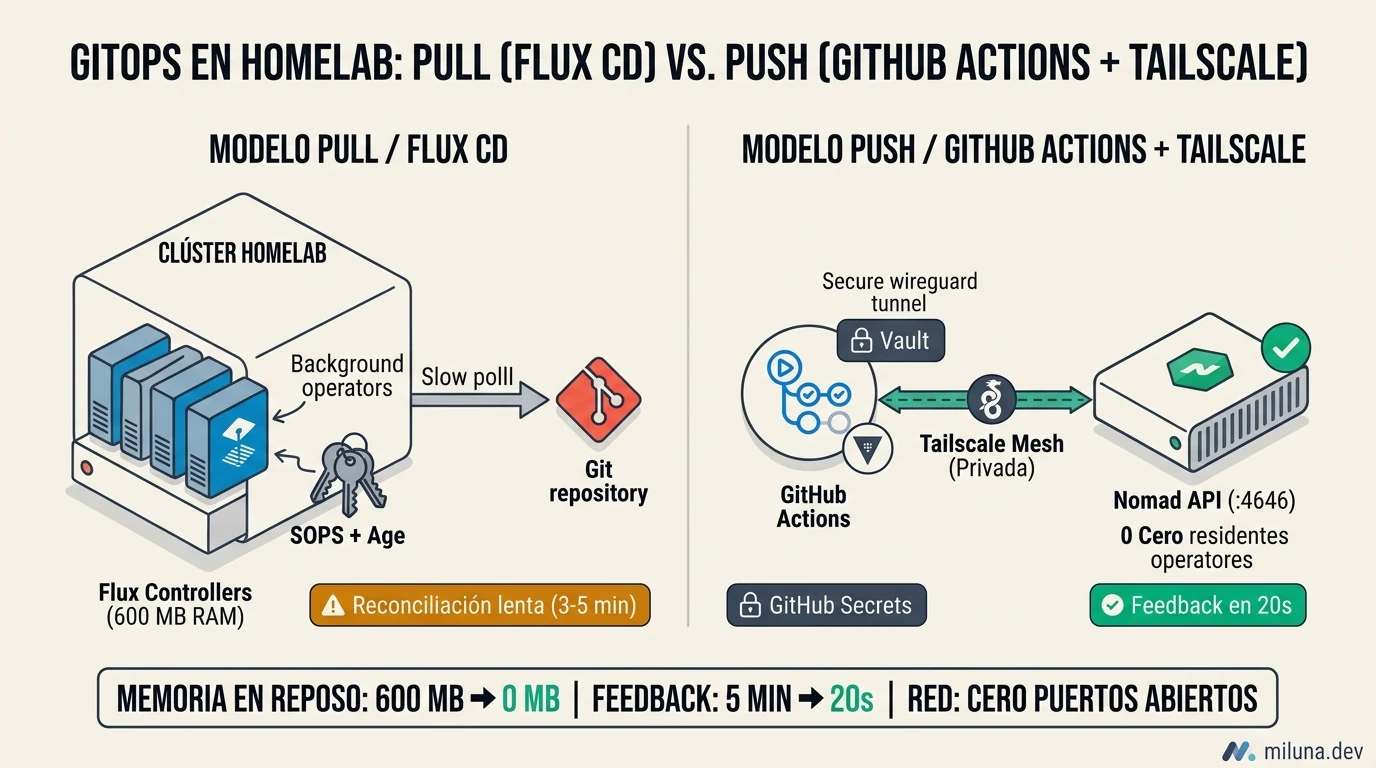
El Dogma del GitOps Pull y Dónde Empieza a Fallar
El modelo Pull (representado por herramientas líderes como Flux CD o ArgoCD) fue concebido para resolver un problema corporativo muy concreto:
- Grandes organizaciones con cientos de clústeres detrás de cortafuegos corporativos infranqueables donde está estrictamente prohibido abrir puertos entrantes.
- Equipos donde los desarrolladores no deben tener acceso de red directo a la infraestructura.
- Entornos a gran escala donde la detección de derivas (drift detection) local es crítica.
[ GitOps Pull Tradicional ]
Repositorio Git <────── Polling continuo (cada 3 min) ────── Controlador in-cluster (Flux/Argo)
                                                                    │
                                                                    ▼
                                                            Aplica al API Server
Sin embargo, trasladar este modelo a un homelab o a un clúster pequeño acarrea costes ocultos que rara vez se mencionan en las charlas de conferencias:
1. El impuesto de memoria de los controladores
Tener tres o cuatro controladores de Flux (source-controller, kustomize-controller, helm-controller, notification-controller) corriendo de forma permanente consume entre 400 MB y 800 MB de RAM base. En servidores con recursos limitados, ese consumo es un desperdicio injustificable para un clúster donde los despliegues ocurren unas pocas veces por semana.
2. El infierno de los operadores de secretos in-cluster
Para no subir secretos en plano a Git, el estándar en GitOps Pull es cifrar los valores con SOPS. Pero el dolor no radicaba en SOPS (que es una excelente herramienta de cifrado basada en Age), sino en tener un operador dentro del clúster descifrando manifiestos continuamente en cada ciclo de reconciliación:
- Mantener controladores corriendo permanentemente para interceptar y descifrar recursos.
- Si una clave Age se desincronizaba tras un reinicio de nodo, o si un secreto fallaba al descifrarse, el reconciliador de Flux se atascaba en bucles infinitos, bloqueando despliegues de servicios totalmente ajenos.
- El clúster entero entraba en parálisis por la fragilidad de la cadena de descifrado residente.
3. Feedback ciego y asíncrono
En el modelo Pull, cuando haces un git push, el pipeline de CI termina inmediatamente en verde porque solo valida que el commit llegó a GitHub. Pero no tienes ni idea de si el servicio arrancó con éxito en producción.
Tienes que abrir terminales, consultar logs del operador o esperar a que el reconciliador despierte minutos después. Si la imagen falla por un CrashLoopBackOff o un typo en una variable de entorno, el fallo ocurre en silencio dentro del clúster.
La Alternativa Pragmática: Push Determinista con Tailscale
Al migrar el clúster a HashiCorp Nomad, decidí replantear el flujo desde cero: ¿qué pasaría si eliminamos todos los operadores del clúster y dejamos que el propio pipeline de integración continua sea el responsable de aplicar los cambios?
La objeción clásica al modelo Push siempre ha sido la seguridad: “No queremos exponer el API de nuestro orquestador a internet ni almacenar credenciales estáticas de acceso en GitHub”.
Aquí es donde entra Tailscale.
[ Git Push a main ]
        │
        ▼
[ GitHub Actions Runner ]
        │  1. Autenticación efímera vía Tailscale (OAuth tag:ci)
        │  2. Cero secretos de aplicación en el runner
        ▼
[ Red Privada Tailscale (Mesh) ]
        │  3. make nomad-jobs-apply contra la API privada (:4646)
        ▼
[ Clúster Nomad (:4646) ] ──> [ Jobs desplegados consumiendo Nomad Variables ]
Cómo funciona la conexión efímera
- El runner de GitHub Actions no necesita IPs fijas ni certificados persistentes.
- Mediante la acción oficial de Tailscale y credenciales OAuth, el runner genera un nodo efímero de un solo uso dentro de mi red privada virtual (tailnet).
- A este nodo se le asigna una etiqueta estricta (
tag:ci). - Las ACLs de Tailscale restringen el acceso de
tag:ciexclusivamente al puerto de la API de Nomad (:4646). No puede acceder a ninguna otra máquina ni servicio de la red. - En cuanto el job de GitHub Actions finaliza, el nodo efímero se destruye y desaparece sin dejar rastro.
Secretos Pragmáticos: SOPS + Nomad Variables en lugar de Operadores o Sprawl de CI
En la gestión de secretos suele haber dos extremos dolorosos:
- La sobreingeniería in-cluster: Desplegar un clúster de HashiCorp Vault (con sus procesos de unsealing, políticas ACL complejas y consumo de RAM) o mantener operadores residentes de Flux/SealedSecrets descifrando continuamente en cada reconciliación.
- El descontrol en CI (CI secret sprawl): Volcar decenas de contraseñas de base de datos y tokens de producción en GitHub Secrets, pasando luego una lista interminable de argumentos
-var="secret=${...}"en cada invocación de despliegue. Esto mezcla la configuración sensible con el pipeline, expone credenciales a los logs del runner y obliga a relanzar pipelines para rotar cualquier valor.
En sr-infra adoptamos un punto medio infinitamente más limpio y profesional: versionado seguro con SOPS en Git y sincronización desacoplada a Nomad Variables.
1. Git como única fuente de verdad (cifrado con SOPS y Age)
Los secretos de cada aplicación residen en archivos dedicados bajo nomad/secrets/*.enc.env. Están completamente cifrados con claves Age mediante Mozilla SOPS, por lo que es 100% seguro versionarlos en Git. Cada archivo incluye metadatos en sus comentarios para declarar su destino en el clúster:
# NOMAD_NAMESPACE=tooling
# NOMAD_VAR_PATH=nomad/jobs/tooling/postgres-backup
DB_HOST="127.0.0.1"
DB_USER="postgres"
DB_PASSWORD="mi_password_seguro"
2. Sincronización desacoplada en memoria (In-Memory Sync)
Los secretos no se descifran en cada commit ni mediante operadores residentes. Se sincronizan una sola vez (o cuando cambian) desde la estación de trabajo mediante un script automatizado (scripts/nomad_secrets_sync.sh o make nomad-secrets-sync):
# Descifra en memoria y carga directamente en el almacén de Nomad Variables
make nomad-secrets-sync
El script utiliza sops -d para descifrar en memoria y ejecuta nomad var put -force contra la API del clúster. Los secretos en texto plano jamás tocan el disco de las máquinas ni se exponen a repositorios públicos.
3. Consumo nativo y transparente en los Jobs de Nomad
Las especificaciones HCL de Nomad consumen estos secretos de forma nativa mediante directivas template:
task "backup" {
  template {
    destination = "secrets/backup.env"
    env         = true
    data        = <<EOF
{{ with nomadVar "nomad/jobs/tooling/postgres-backup" }}
DB_HOST="{{ .db_host }}"
DB_USER="{{ .db_user }}"
DB_PASSWORD="{{ .db_password }}"
{{ end }}
EOF
  }
}
Nomad inyecta los valores en el contenedor de forma segura en memoria al arrancar la tarea.
4. Mínimo privilegio en CI/CD y rotación instantánea
- GitHub Actions no conoce contraseñas de negocio: En GitHub Secrets solo residen las credenciales efímeras de Tailscale (
TS_OAUTH_CLIENT_IDyTS_OAUTH_SECRET). El pipeline de CI solo empuja código y especificaciones HCL, jamás secretos de aplicación. - Rotación desacoplada: Si necesitas rotar una clave de API o una contraseña de base de datos, no necesitas hacer un commit de código ni disparar un despliegue de CI. Modificas el archivo cifrado con
sops nomad/secrets/..., ejecutasmake nomad-secrets-sync, y Nomad actualiza la variable en memoria y reinicia o recarga suavemente los contenedores afectados.
El Pipeline en Acción: .github/workflows/nomad.yml
A continuación se muestra el workflow real y funcional que utilizamos para validar, planificar y desplegar los trabajos en Nomad a través de Tailscale:
# .github/workflows/nomad.yml
name: Nomad CI/CD

on:
  pull_request:
    branches: [main]
    paths:
      - 'nomad/jobs/**'
  push:
    branches: [main]
    paths:
      - 'nomad/jobs/**'

jobs:
  validate:
    name: "Validate Nomad Jobs"
    runs-on: ubuntu-latest
    steps:
      - name: Checkout repository
        uses: actions/checkout@v4

      - name: Setup Nomad CLI
        uses: hashicorp/setup-nomad@v2

      - name: Validate Job Specifications
        run: make nomad-jobs-verify

  deploy:
    name: "Apply Nomad Jobs"
    needs: validate
    if: github.ref == 'refs/heads/main' && github.event_name == 'push'
    runs-on: ubuntu-latest
    steps:
      - name: Checkout repository
        uses: actions/checkout@v4

      - name: Setup Nomad CLI
        uses: hashicorp/setup-nomad@v2

      - name: Connect to Tailscale
        uses: tailscale/github-action@v2
        with:
          oauth-client-id: ${{ secrets.TS_OAUTH_CLIENT_ID }}
          oauth-secret: ${{ secrets.TS_OAUTH_SECRET }}
          tags: tag:ci

      - name: Apply Nomad Jobs to Cluster
        env:
          NOMAD_ADDR: http://travolta.your-tailnet.ts.net:4646
        run: make nomad-jobs-apply
Las Ganancias Operativas Reales
Tras varios meses operando este modelo, las ventajas respecto a la etapa de Flux son evidentes:
| Dimensión | Enfoque Anterior (Flux CD Pull) | Enfoque Actual (GitHub Actions Push + Nomad) |
|---|---|---|
| Memoria consumida en reposo | ~600 MB en controladores in-cluster | 0 MB (todo el pipeline se ejecuta fuera del clúster) |
| Gestión de secretos | SOPS + claves Age + operadores de descifrado | SOPS en Git + sincronización desacoplada a Nomad Variables |
| Secretos en CI/CD | Claves privadas inyectadas en el clúster | Cero secretos de negocio en GitHub (solo OAuth Tailscale) |
| Tiempo de feedback | 3 - 8 minutos (polling asíncrono) | < 25 segundos con log de fallo en tiempo real |
| Superficie de red pública | Cero puertos expuestos | Cero puertos expuestos (acceso vía Tailscale mesh) |
| Recuperación ante desastres | Requiere restaurar claves y controladores | Inmediata: un make nomad-jobs-apply reconstruye el clúster |
La Letra Pequeña: ¿Qué Trade-offs Asumimos?
Para ser técnicamente rigurosos, este modelo Push no está exento de compromisos:
-
Pérdida de detección continua de deriva (drift detection):
Si alguien modifica manualmente un trabajo ejecutandonomad job stopo alterando la configuración por CLI en el servidor, GitHub Actions no se enterará de inmediato hasta el siguiente commit (a menos que programes un workflow periódico conschedule). En un equipo pequeño o proyecto personal esto no suele ser un problema, pero en organizaciones con decenas de desarrolladores el drift puede pasar inadvertido. -
Dependencia de la disponibilidad de GitHub Actions:
Si la infraestructura de GitHub sufre una caída de servicio, no podrás desplegar nuevas versiones a través de tu flujo habitual. Sin embargo, dado que tienes acceso directo por Tailscale, siempre puedes desplegar manualmente en segundos desde tu máquina local ejecutandomake nomad-jobs-apply. -
Confianza en la seguridad de Tailscale:
Delegamos el túnel de autenticación a Tailscale. Sin embargo, al haber desacoplado los secretos mediante SOPS y Nomad Variables, GitHub jamás custodia las contraseñas de producción ni las credenciales de bases de datos; solo almacena credenciales efímeras de Tailscale (tag:cirestringida estrictamente al puerto:4646), reduciendo drásticamente el radio de impacto ante cualquier vulnerabilidad en CI.
Conclusión: Elige Herramientas a la Medida de tu Problema
GitOps Pull con Flux o ArgoCD es una tecnología extraordinaria si administras cientos de clústeres en entornos regulados donde la red interna es hostil.
Pero en entornos pequeños, medianos o laboratorios personales, forzar el modelo Pull suele ser un ejercicio de sobreingeniería. Te añade capas de abstracción, operadores residentes que devoran RAM y dolores de cabeza con secretos cifrados para resolver problemas que no tienes.
Combinar un orquestador ligero como Nomad, una malla privada como Tailscale y la simplicidad de GitHub Actions nos ofrece lo mejor de ambos mundos: cero puertos expuestos, cero memoria desperdiciada en el clúster y un feedback inmediato en cada despliegue.