Aventuras con mi homelab: de K3s a Nomad para recuperar mi tiempo libre (Parte 2)
En la primera parte de esta serie dejamos a Travolta y Thurman, mis dos mini PCs Intel N150 con 16 GB de RAM, al borde del colapso funcional.
Había montado un clúster de K3s con todas las campanas y silbatos imaginables: operadores de bases de datos, almacenamiento distribuido con Longhorn forzado en dos nodos, GitOps con Flux CD y una suite de observabilidad con Grafana Mimir y Loki HA que consumía más de 7 GB de memoria RAM antes de desplegar una sola API propia.
El resultado fue tan predecible como doloroso: me había convertido en el ingeniero de guardia no remunerado de mi propia casa. Cada domingo por la tarde terminaba apagando fuegos provocados por volúmenes degradados, pods atascados en Terminating o bucles de reconciliación en Flux.
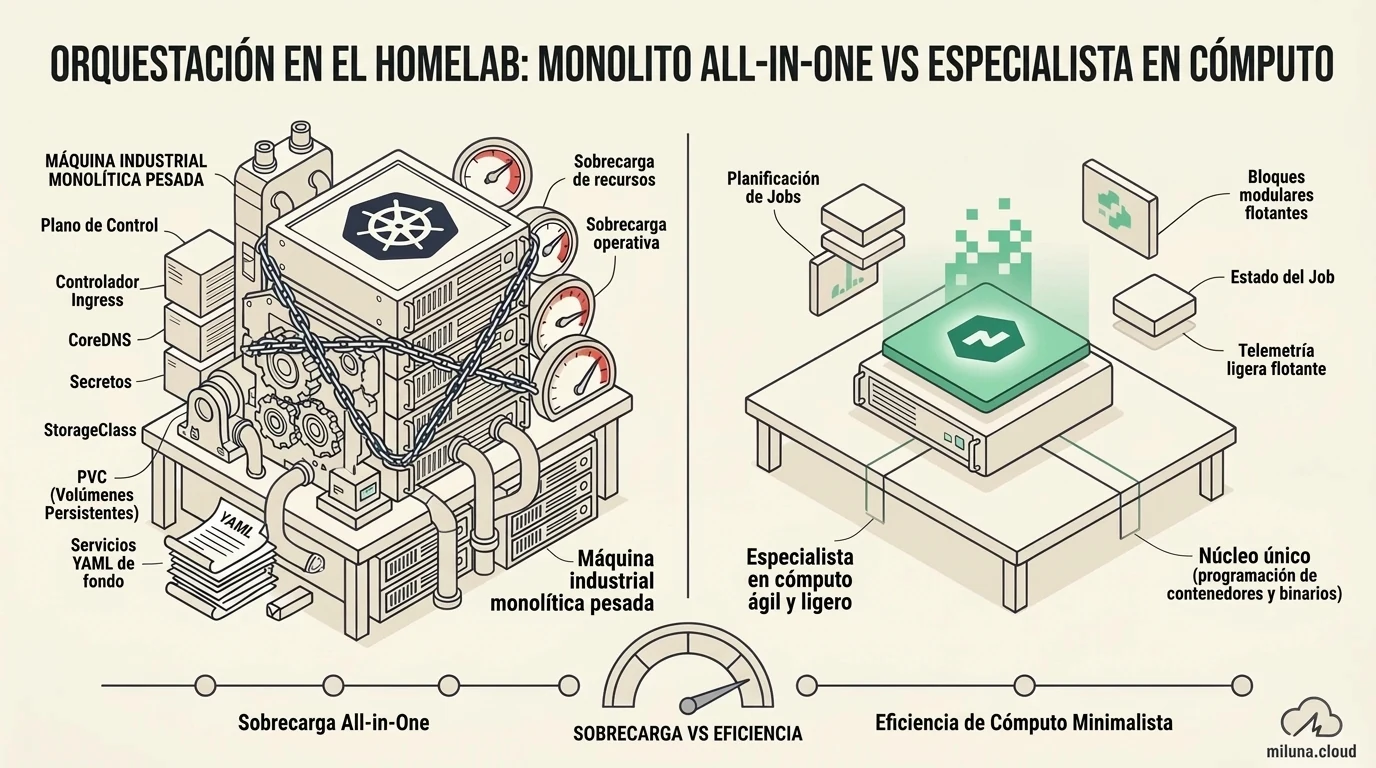
Había que parar y aplicar cirugía mayor. Este artículo es la crónica de cómo desmantelé esa torre de naipes y reconstruí la infraestructura bajo una premisa radicalmente distinta: menos complejidad accidental, máxima disponibilidad de recursos y foco absoluto en el cómputo.
La Decisión: El Clúster es Solo para Cómputo
El principal pecado de mi arquitectura inicial fue intentar replicar las comodidades de AWS o GCP en dos cajas de 150 euros sobre mi escritorio.
En un clúster casero de dos nodos físicos, el consenso distribuido estricto no perdona. Mantener almacenamiento replicado por bloques y clústeres de bases de datos exigía un peaje operativo desmedido. La primera decisión de diseño fue cortar de raíz dos grandes fuentes de fricción:
1. Fuera StatefulSets: PostgreSQL nativo en Travolta y backups automáticos a Cloudflare R2
En dos nodos, si Thurman se reiniciaba por una actualización de kernel, Longhorn perdía el 50% de sus réplicas de disco y entraba en pánico. Además, gestionar operadores pesados como CloudNativePG y Percona MongoDB en hardware modesto era una fuente inagotable de fricción.
La solución pragmática: dejar de fingir que tenemos un clúster de almacenamiento distribuido enterprise y desacoplar la persistencia del orquestador:
- PostgreSQL 16 nativo en el servidor (Travolta): En lugar de forzar réplicas de almacenamiento distribuido frágiles o depender de bases de datos serverless en la nube (que introducen latencia de red de 20 ms, pausas por cold start y límites de cuota), instalamos PostgreSQL directamente sobre Travolta mediante un servicio nativo de
systemd, aprovisionado de forma idempotente con Ansible. - Rendimiento instantáneo y huella mínima: Disfrutamos de latencia sub-milisegundo (< 0.5 ms) sobre disco NVMe local, cero penalización de arranque para ingesta de datos y bots de trading, y un consumo contenido de apenas 150–250 MB de RAM en reposo.
- Conectividad segura sin exponer puertos: Los servicios que corren en el propio Travolta conectan localmente por
127.0.0.1:5432, mientras que las tareas en Thurman o máquinas de desarrollo conectan de forma cifrada a través de la malla de Tailscale (100.64.0.0/10/travolta-tailscale:5432) con autenticación SCRAM-SHA-256. - Backups a Cloudflare R2 orquestados por Nomad: El estado no se custodia mediante replicación síncrona compleja entre dos nodos; se protege mediante un trabajo batch periódico en Nomad (
postgres-backup.nomad.hcl) que ejecuta a diarioscripts/postgres-backup.sh. Genera volcados locales comprimidos con retención rodante de 7 días y los sincroniza medianterclonedirectamente a un bucket de Cloudflare R2 (homelab-backups/postgres/), con visibilidad de logs y alertas en la UI de Nomad.
2. Observabilidad de primer nivel pero sin overhead: Grafana Cloud
Tener Grafana Alloy recolectando hacia un clúster local de Loki en alta disponibilidad y un backend Mimir sincronizando bloques contra R2 era pura vanidad técnica para monitorizar un par de microservicios: consumía más de 4 GB de memoria solo en mantener vivos los compadictadores, anillos memberlist e indexadores.
Pero prescindir de la visibilidad tampoco era una opción: tener métricas con Prometheus, logs centralizados con Loki y alertas configuradas es indispensable. La jugada maestra fue externalizar toda la observabilidad a Grafana Cloud (Free Tier):
- El tier gratuito incluye 10.000 series de métricas, 50 GB de logs y 50 GB de trazas mensuales, un margen inmenso para cualquier entorno de desarrollo o homelab.
- En lugar de procesar y almacenar telemetría en mis propios nodos, un único agente ultraligero de Grafana Alloy con un consumo mínimo (~50-80 MB) se limita a recopilar métricas del host y logs de contenedores para reenviarlos directamente a la nube de Grafana.
- El beneficio: Mantengo exactamente la misma experiencia y calidad de dashboards y alertas que tenía en K3s, pero recuperando al instante más de 6 GB de RAM libres para mis aplicaciones.
Con la pizarra en blanco y el hardware respirando de nuevo, la pregunta era evidente: ¿seguía teniendo sentido arrastrar el peso del plano de control de Kubernetes?
El Nuevo Motor: Por Qué HashiCorp Nomad
K3s es una maravilla de la ingeniería para empaquetar Kubernetes en un binario reducido, pero sigue siendo Kubernetes: un API server voraz, k3s-server, controladores, kubelet, un CNI de red overlay (Flannel) y docenas de CRDs vigilando el estado.
El drama del plano de control en dos nodos: K3s vs. Nomad
Montar Kubernetes en un clúster de solo dos nodos (Travolta y Thurman) es una lección acelerada de sistemas distribuidos… y de sufrimiento operativo. La matemática del consenso distribuido no hace concesiones:
- En etcd, el quórum requiere una mayoría estricta:
(N/2) + 1. Con 2 nodos, el quórum necesario es 2. Si pierdes un solo nodo, pierdes el quórum (1 < 2), etcd entra en modo de solo lectura y el plano de control se congela por completo para evitar situaciones de split-brain. - Si optas por el esquema clásico de homelab con un nodo maestro (control plane en Travolta) y un nodo de trabajo (worker en Thurman) con SQLite embebido (Kine), el escenario es igual de frágil: si Travolta cae o su base de datos se corrompe, el clúster queda decapitado.
Recuperar ese plano de control caído en K3s es una pesadilla de fin de semana: lidiar con flags de emergencia como k3s server --cluster-reset, restaurar snapshots de etcd desfasados, regenerar tokens de unión, resolver certificados TLS caducados o corruptos, y limpiar las interfaces virtuales huérfanas que Flannel e iptables dejan tras de sí. Si decides promover al worker superviviente como nuevo servidor, la receta suele implicar desinstalar agentes, purgar directorios /var/lib/rancher/k3s y rezar para que los manifiestos no se hayan perdido por el camino.
En Nomad, el contraste es abismal:
Nomad es un único binario compilado en Go que puede actuar como servidor (server), agente de ejecución (client) o ambos a la vez. Al haber desacoplado el estado de los trabajos de cómputo y protegido la base de datos con backups automatizados a Cloudflare R2 y configuración en Git, el servidor de Nomad no custodia configuraciones irreemplazables en su propio plano de control: solo coordina tareas.
Si la máquina que actúa como servidor cae, reconstruir el plano de control en el nodo superviviente toma exactamente 30 segundos:
- Abres
/etc/nomad.d/nomad.hcly declaras el rol de servidor:
server {
  enabled          = true
  bootstrap_expect = 1
}

client {
  enabled = true
}- Ejecutas
sudo systemctl restart nomad.
¿Hay downtime? Sí, un par de minutos mientras el nodo superviviente asume el rol y programa los trabajos. ¿Hay que rehacer todo el clúster desde cero? En absoluto. No es la catástrofe existencial de perder etcd en Kubernetes, donde te quedas a oscuras en un laberinto de certificados corruptos, nodos en NotReady y recuperaciones a ciegas. En Nomad es un incidente menor, determinista y aburrido: cambias dos líneas de configuración, reinicias el binario, disparas el pipeline de GitHub Actions (o ejecutas nomad job run *.nomad.hcl) y los contenedores vuelven a estar arriba de inmediato. Sin cirugías de quórum, sin regenerar certificados y sin depurar marañas de CNI.
El valor del aprendizaje frente al coste del overhead
Hay que ser justos: operar Kubernetes enseña muchísimo. Pelear contra etcd, descifrar los loops de reconciliación de sus controladores, configurar CNI overlays y entender la inmutabilidad de los Pods te convierte en mejor ingeniero de infraestructura. Te obliga a comprender cómo piensan y escalan las grandes plataformas distribuidas del mundo. Recomiendo a cualquiera pasar por esa experiencia en un entorno de laboratorio.
Pero hay una delgada línea entre aprender ingeniería distribuida y pagar un peaje operativo perpetuo. Para un clúster personal o un homelab de dos nodos, la maquinaria de Kubernetes es desproporcionada. Te exige mantener un transatlántico cuando lo que necesitas es cruzar el río. Nomad ofrece el 90% de los beneficios reales de orquestación (salud de procesos, balanceo, reinicios automáticos, despliegues declarativos) con apenas un 5% de la fricción operativa. Respeta tu tiempo y tu hardware.
La analogía cloud: El enfoque ECS vs. EKS
Para entender el cambio de paradigma, la mejor analogía en el mundo cloud es la diferencia entre AWS ECS y AWS EKS (Kubernetes):
- Kubernetes (EKS) busca ser un sistema operativo distribuido absoluto: abstrae la red, el almacenamiento, el DNS y el ciclo de vida bajo capas infinitas de abstracción e indirección.
- AWS ECS, en cambio, abraza el pragmatismo: es un orquestador centrado puramente en cómputo. Defines una tarea (Task Definition) con sus recursos de CPU y memoria, y ECS se encarga de colocar los contenedores en las instancias y conectarlos a un balanceador (ALB), delegando las bases de datos y el estado a servicios externos.
Nomad es, en esencia, tener la filosofía directa y eficiente de AWS ECS en tu propio hardware. No intenta reinventar un universo de almacenamiento ni forzarte a encapsular paquetes; se enfoca en ser un programador (scheduler) de tareas impecable, rápido y predecible:
- Un único ejecutable de 70 MB: Nomad viene compilado en un único binario estático de Go. No requiere etcd externo; utiliza el protocolo Raft integrado para consenso entre servidores.
- Consumo insignificante: El agente de Nomad corre como servidor y cliente consumiendo apenas 80-100 MB de memoria RAM en cada máquina.
- Cero red overlay obligatoria: A diferencia de Flannel o Calico, Nomad no necesita encapsular paquetes en VXLAN para que los contenedores hablen entre sí. Se apoya en la red del host o en interfaces puente estándar de Linux.
- Modelo conceptual limpio: Se acabaron los despliegues fragmentados en cinco manifiestos YAML (
Deployment,Service,Ingress,ConfigMap,HPA). En Nomad, una aplicación completa se define en un único archivo declarativo HCL (job).
# api-service.nomad.hcl
job "api-service" {
  datacenters = ["homelab"]
  type        = "service"

  group "web" {
    count = 2

    network {
      port "http" {
        to = 8080
      }
    }

    service {
      name     = "api-service"
      port     = "http"
      provider = "nomad"

      tags = [
        "traefik.enable=true",
        "traefik.http.routers.api.rule=Host(`api.miluna.dev`)"
      ]

      check {
        type     = "http"
        path     = "/health"
        interval = "10s"
        timeout  = "2s"
      }
    }

    task "server" {
      driver = "docker"

      config {
        image = "ghcr.io/miluna/api-service:latest"
        ports = ["http"]
      }

      resources {
        cpu    = 200
        memory = 256
      }
    }
  }
}
Nomad categoriza los trabajos por su ciclo de vida real: service para aplicaciones continuas, batch para tareas con inicio y fin (como un script de backup), y system para servicios que deben correr en todos los nodos (como un proxy inverso).
Enrutamiento Dinámico Consistente: Traefik y Cloudflare Tunnel en Nomad
Uno de los choques culturales al pasar de Kubernetes a Nomad es la gestión de puertos: en Nomad, las tareas reciben puertos dinámicos efímeros asignados por el scheduler en el host, evitando colisiones entre réplicas.
Para enrutar tráfico de forma homogénea sin dependencias sueltas en el sistema operativo, toda la capa de entrada corre como trabajos de tipo system en Nomad (una réplica obligatoria por nodo):
- Traefik con integración nativa: Escucha en el puerto 80 de cada máquina y se conecta a la API local de Nomad (
http://localhost:4646). Cuando Nomad levanta una réplica en un puerto aleatorio (como vimos en el manifiesto anterior conto = 8080), Traefik detecta automáticamente sus etiquetas (traefik.http.routers...) y reconfigura sus tablas de enrutamiento al vuelo sin recargar servicios. - Cloudflare Tunnel containerizado: En lugar de instalar
cloudflaredcomo un servicio huérfano desystemd, corre orquestado como tarea del clúster con réplicas redundantes en Travolta y Thurman.
El resultado es una red 100% declarativa y segura: las peticiones externas llegan cifradas a través de la red global de Cloudflare, se entregan localmente a Traefik y se distribuyen entre las réplicas activas sin abrir jamás un solo puerto en el router doméstico.
Adiós a Flux: Despliegues Directos con GitHub Actions y Tailscale
En la etapa con K3s, seguía religiosamente el dogma del GitOps Pull con Flux CD: múltiples controladores vigilando repositorios cada tres minutos, secretos cifrados con SOPS y bucles de reconciliación que, ante cualquier degradación de memoria, se convertían en una trampa de CRDs rotos.
Para esta nueva etapa, abracé el pragmatismo de un Push determinista desde GitHub Actions:
[ Git Push / Merge ]
        │
        ▼
[ GitHub Actions Runner ]
        │  1. Autenticación efímera con Tailscale (OAuth tag:ci)
        │  2. Cero secretos de aplicación en CI (residen en Nomad Variables)
        ▼
[ Travolta / Thurman (:4646) ] ──> nomad job run contra la API privada- Cero operadores in-cluster: En lugar de malgastar cientos de megabytes de RAM en controladores de GitOps residentes, el despliegue lo empuja el runner de GitHub solo cuando hay un cambio en la rama principal.
- Malla privada efímera con Tailscale: El runner se autentica como nodo temporal mediante OAuth en mi red privada (tailnet) y ejecuta
nomad job rundirectamente contra la API de Nomad, mientras que las cargas toman sus secretos de forma nativa desde las Nomad Variables aprovisionadas con SOPS. - Feedback instantáneo: Si la imagen falla al arrancar o el healthcheck no responde, el pipeline de CI/CD se tiñe de rojo en 20 segundos con el log exacto del error, sin esperar a que un operador en el clúster se entere.
💡 Artículo complementario:
La comparativa en profundidad entre GitOps Pull (Flux/ArgoCD) vs. Push (GitHub Actions + VPN), el desglose de seguridad y el workflow completo de CI/CD los analizamos en detalle en su propio artículo dedicado: Por qué abandoné Flux: el caso de GitHub Actions y Tailscale para despliegues ligeros →.
La Letra Pequeña: Los Downsides Reales del Nuevo Setup
Desmontar Kubernetes para abrazar Nomad y un enfoque stateless no es una solución mágica sin concesiones. Para ser rigurosos con la ingeniería, hay que mirar de frente a los compromisos que asumimos al cambiar de modelo:
| Característica | Kubernetes (K3s) Anterior | HashiCorp Nomad + Cloud Actual |
|---|---|---|
| Plano de control | Pesado (~1.5 - 2 GB RAM base) | Ultraligero (~80 - 100 MB RAM base) |
| Aislamiento de red | 100% On-Premise / Air-gapped posible | Híbrido: BD y cómputo locales, telemetría y backups en Cloud |
| Bases de datos | Clúster pesado in-cluster (Longhorn + CloudNativePG) | PostgreSQL 16 nativo en Travolta + Backups periódicos a Cloudflare R2 vía Nomad |
| Observabilidad | Suite pesada local (Mimir + Loki HA) | Grafana Cloud Free Tier (Datos fuera de la red local) |
| Despliegues & CI | Pull in-cluster con Flux + SOPS | Push vía GitHub Actions conectando por Tailscale |
| Ecosistema | Helm, CRDs y operadores comunitarios | Manifiestos HCL escritos a mano (artesanales) |
| Licencia | Open Source (Apache 2.0 / CNCF) | HashiCorp BSL (Business Source License) |
1. Dependencia híbrida de servicios externos
En el setup anterior con K3s, si la fibra de casa se cortaba o si la conexión parpadeaba, el clúster seguía viviendo de forma autónoma: las bases de datos y las métricas se almacenaban en discos locales.
Al alojar PostgreSQL directamente sobre Travolta, las aplicaciones locales y los bots conservan autonomía completa y latencia sub-milisegundo sin depender de Internet. Sin embargo, mantenemos integración híbrida con servicios cloud:
- Si cae la conexión a Internet, la telemetría no llega a Grafana Cloud, los túneles de Cloudflare Tunnel quedan inoperativos y los backups periódicos no pueden subir a Cloudflare R2 (aunque se siguen conservando localmente en
/var/backups/postgresql/). - Si mañana Grafana Cloud o Cloudflare recortan las cuotas de sus tiers gratuitos, tocará reajustar retenciones o asumir pequeños costes de almacenamiento.
2. Base de datos anclada a un nodo único vs. el mito de la alta disponibilidad en 2 máquinas
Al renunciar a operadores de replicación distribuida entre dos máquinas o a bases de datos gestionadas en la nube, asumimos un compromiso de diseño honesto:
- Punto único de persistencia física: PostgreSQL corre como servicio
systemden Travolta. Si Travolta sufre un fallo de hardware catastrófico en disco o placa base, la base de datos queda interrumpida hasta restaurar el último volcado desde Cloudflare R2 en Thurman o en una máquina de reemplazo. - Disciplina operativa de backups: La resiliencia no depende de la “magia” del almacenamiento distribuido síncrono, sino de comprobar regularmente que los volcados automáticos diarios en Cloudflare R2 son íntegros y restaurables.
- Para un homelab de dos máquinas físicas, este enfoque pragmático es infinitamente más predecible que la falsa ilusión de alta disponibilidad de Longhorn, que corrompía volúmenes y bloqueaba réplicas ante cualquier parpadeo de red entre nodos.
3. El síndrome de la “artesanía” en Nomad vs. el ecosistema de Helm
Kubernetes ha ganado la batalla de la industria porque cualquier desarrollador puede ejecutar helm repo add y desplegar un clúster de Kafka, Redis o un CMS en cuestión de minutos gracias al trabajo comunitario.
En Nomad estás solo ante el peligro:
- No hay un repositorio central de paquetes como Helm: Si quieres desplegar una cola de mensajería o un servicio de terceros, te toca redactar la especificación
.nomad.hclde forma manual. - Te obliga a entender y configurar al detalle los límites de CPU/RAM, los healthchecks de Traefik y los mapeos de puertos efímeros en cada servicio. Ganas un control quirúrgico y entiendes cada byte que corre en tu máquina, pero inviertes tiempo escribiendo configuración declarativa desde cero.
4. Superficie de seguridad: abrir la red privada a GitHub Actions
Con Flux CD, todo el ciclo de entrega era pull y vivía dentro del perímetro del clúster; los secretos se descifraban con claves privadas que jamás salían de las máquinas físicas.
Con el modelo de GitHub Actions:
- Un runner efímero en la nube de Microsoft recibe credenciales de Tailscale (
tag:ci) y se une temporalmente a la red privada de mi casa para invocar la API de Nomad. - Aunque Tailscale permite aplicar ACLs muy estrictas para limitar a qué IPs y puertos puede hablar el runner, estás confiando en la seguridad de GitHub Secrets y en que ningún paso del pipeline sea vulnerado. Además, si GitHub Actions o Tailscale sufren una degradación de servicio, tus despliegues quedan totalmente congelados.
Resultados: El Clúster al Servicio del Código
El impacto tras completar la migración de Travolta y Thurman fue inmediato tanto en métricas como en paz mental:
| Métrica | K3s + In-Cluster (Antes) | Nomad + Cloudflare (Ahora) |
|---|---|---|
| RAM en reposo | > 7 GB (~45% del hardware) | < 450 MB (< 3% del hardware) |
| Memoria libre para apps | ~8 GB compartidos | ~30 GB limpios y dedicados |
| Riesgo de split-brain | Constante (almacenamiento en 2 nodos) | Cero (cómputo 100% stateless) |
| Tiempo de despliegue | 2–5 min (reconciliación de Flux) | < 30 segundos (GitHub Actions directo) |
| Mantenimiento | Semanal (parches, CRDs, PVCs) | Desatendido (binario estático) |
Las cuatro grandes victorias
-
Potencia cloud sin factura mensual: Disponer de casi 30 GB de memoria neta utilizable para proyectos personales es un margen descomunal. En AWS, mantener 32 GB de RAM dedicados 24/7 (instancias tipo
m6i.2xlargeot4g.2xlarge) costaría entre 120 y 150 dólares al mes solo en cómputo. En mi escritorio corre de forma silenciosa, ilimitada y a coste cero. -
Alta escalabilidad sin el fantasma del split-brain: En K3s, escalar o mover pods era un campo de minas por la falta de quorum en Longhorn. Al anclar PostgreSQL como servicio fiable en Travolta y desacoplar los backups a R2, el clúster de cómputo en Nomad es puramente elástico: subir un servicio de 2 a 10 réplicas o mover tareas entre nodos se hace en segundos sin miedo a particiones de red o volúmenes degradados.
-
Cero fatiga de mantenimiento y menos ruido mental: Se acabaron los volúmenes en
Degraded, los operadores peleándose con CRDs incompatibles y la burocracia de namespaces. Actualizar el clúster se redujo a unapt upgrade nomad(o sustituir un binario) y reiniciar el servicio desystemd. Cero incidencias los domingos. -
Despliegues deterministas con feedback en 20 segundos: Del commit en Git al contenedor corriendo en producción casera pasan menos de 30 segundos. Si algo falla (healthcheck, memoria, sintaxis), GitHub Actions se pone en rojo al instante con el log exacto, sin bucles de reconciliación opacos.
La lección de fondo:
El mayor aprendizaje con un homelab no consiste en aprender a dominar herramientas cada vez más complejas, sino en saber cuándo detener el sobre-diseño. La infraestructura debe trabajar para ti, no al revés. Travolta y Thurman han dejado de ser mi segundo trabajo para volver a ser lo que siempre debieron ser: el patio de recreo perfecto para crear software.