Cómo migramos una base de datos crítica sin tirar el servicio
Migrar una base de datos en producción siempre impone respeto, pero hacerlo en una pasarela de pagos donde cada segundo cuenta es otro nivel. Cuando trabajaba en Klarna, nos tocó dar el salto de una instancia tradicional de PostgreSQL a AWS Aurora sin que los usuarios notasen una caída del servicio.
Aquí te cuento la estrategia que seguimos, las decisiones que tomamos y cómo lo ejecutamos a las 3 de la madrugada.
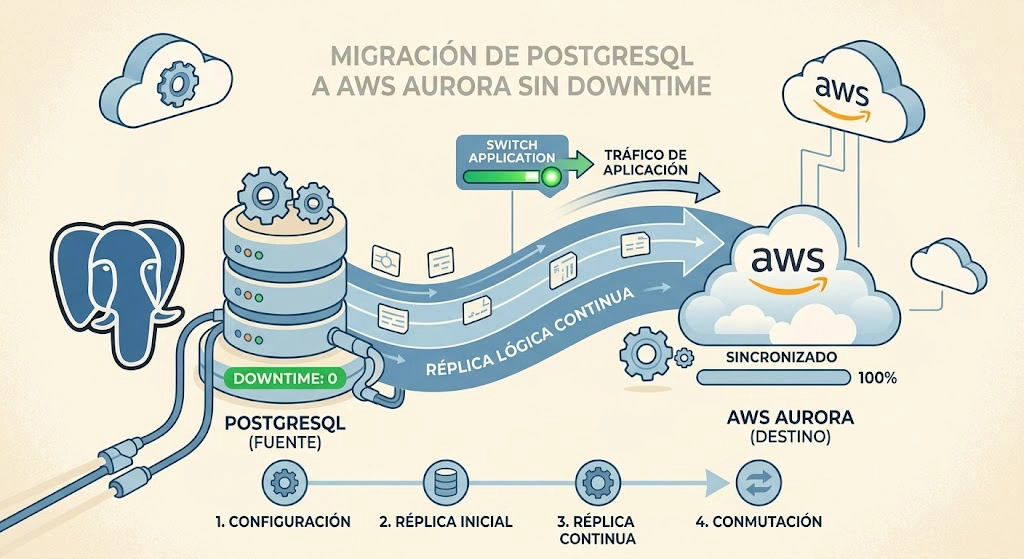
1. ¿Por qué cambiar de base de datos?
El motivo principal fue el rendimiento y los costes. Nuestra base de datos original corría sobre una única instancia grande (tamaño XL). A medida que crecía el tráfico, escalar verticalmente salía carísimo y creaba un punto único de fallo.
AWS Aurora nos abría la puerta a una arquitectura mucho más limpia: separar lecturas de escrituras. En lugar de pagar por un servidor gigante para todo, podíamos tener una instancia adecuada para escrituras y varias réplicas pequeñas y elásticas para absorber las lecturas.
Pero para llegar ahí, primero había que mover todos los datos sin cortar el servicio.
2. La estrategia: cómo evitar el apagón
El reto era evidente: ¿cómo cambias el motor debajo de un coche mientras va a 120 km/h por la autopista?
Dividimos la solución en tres pilares:
- Replicación continua en segundo plano: Levantamos la instancia de Aurora a partir de un snapshot de PostgreSQL y configuramos replicación continua mediante AWS DMS (Database Migration Service) para mantener ambas bases de datos sincronizadas en tiempo real.
- Enrutamiento ágil con Route 53: En lugar de desplegar una nueva versión de la aplicación para cambiar las variables de entorno, configuramos un registro DNS en Amazon Route 53 con un TTL muy bajo (30 segundos). Así, el microservicio podía conmutar de base de datos en cuestión de segundos.
- Degradación controlada (Modo solo lectura): Para evitar inconsistencias o transacciones perdidas en el momento exacto del corte, decidimos no permitir escrituras durante unos minutos. Controlamos esto con un feature flag: al activarlo, cualquier endpoint de escritura devolvía temporalmente un código
503 Service Unavailable, mientras que las lecturas seguían funcionando sin inmutarse.
3. El momento del cambio: las 3:00 AM
Elegimos la madrugada de un día de baja actividad para minimizar el impacto si algo se torcía.
La secuencia fue milimétrica:
- Chequeo de sincronización: Confirmamos que el retardo (replication lag) entre PostgreSQL y Aurora fuera prácticamente cero.
- Corte de escrituras: Activamos el feature flag. El microservicio pasó a modo solo lectura.
- Drenaje de transacciones: Esperamos a que DMS aplicase los últimos registros pendientes.
- Cambio de DNS: Actualizamos el registro de Route 53 apuntando a AWS Aurora.
- Estabilización de conexiones: Monitorizamos cómo las conexiones activas en PostgreSQL caían a cero y empezaban a entrar en Aurora.
- Reapertura de escrituras: Desactivamos el feature flag. El sistema volvió a operar al 100%.
4. Resultados y aprendizajes
Toda la operación nos llevó unos 30 minutos entre verificaciones y monitorización. ¿El impacto real en los usuarios? Apenas 3 minutos sin poder realizar operaciones de escritura; el resto del servicio y las consultas de lectura funcionaron de forma ininterrumpida.
Migrar sin caídas no siempre significa “cero fallos mágicos”, sino planificar y controlar la degradación:
- El tiempo invertido en probar el TTL de DNS y los feature flags antes de tocar producción fue lo que nos dio tranquilidad.
- Diseñar tu microservicio para que tolere un modo read-only temporal salva la consistencia de tus datos sin obligarte a apagar la aplicación.