Arquitectura hexagonal en sistemas distribuidos: lecciones en automoción
Acoplar la lógica de negocio a un framework como Spring Boot o a una base de datos es como soldar el motor de un coche directamente al chasis: al primer bache, la vibración parte la estructura entera. Cuando trabajaba en Daimler en la plataforma de vehículos conectados, nos enfrentamos exactamente a este dilema.
Teníamos decenas de microservicios procesando datos y cada cambio en un servicio de terceros o en el esquema de base de datos provocaba un efecto dominó inasumible.
Para cortar de raíz esa fragilidad, apostamos por arquitectura hexagonal combinada con CQRS en Java. Aquí te cuento cómo lo diseñamos, qué atajos nos explotaron en la cara y qué aprendimos tras llevarlo a producción.
1. ¿Por qué el cambio? El problema inicial
La mayoría de servicios nacen con la típica arquitectura en capas (Controller ➔ Service ➔ Repository) centrada en Spring Data JPA. Al principio todo va rápido, pero a medida que el sistema crece, aparecen tres cuellos de botella críticos:
- El framework secuestra el dominio: Las entidades de negocio están plagadas de anotaciones de Hibernate (
@Entity,@Table,@ManyToOne). Cambiar la persistencia exige tocar la lógica de negocio. - Tests de integración lentos: Para validar cualquier regla de negocio trivial necesitábamos arrancar el contexto completo de Spring con
@SpringBootTest. Los pipelines de CI/CD pasan de tardar minutos a rozar la media hora. - Lecturas y escrituras compitiendo: La misma entidad servía para validar operaciones transaccionales complejas y para alimentar paneles de consulta, degradando el rendimiento general.
2. La estrategia: puertos, adaptadores y CQRS
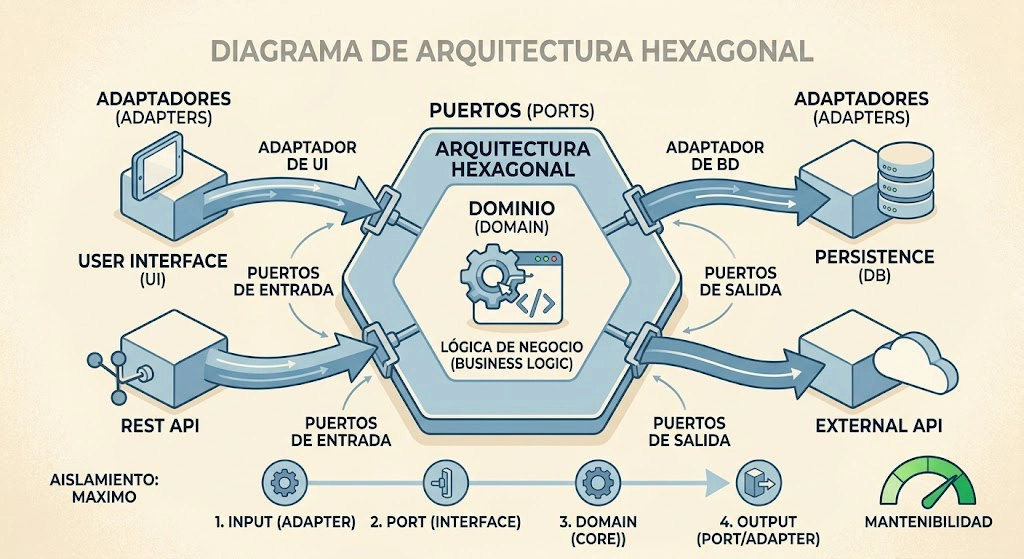
La meta era que el dominio fuese Java puro, completamente agnóstico de frameworks, brokers o bases de datos. Dividimos la arquitectura en tres pilares:
- Puertos y Adaptadores: El núcleo de la aplicación define puertos (interfaces Java puras) para lo que entra y lo que sale. La infraestructura externa (controladores REST, clientes de mensajería o repositorios PostgreSQL) son adaptadores que implementan esos contratos. Si mañana cambiamos de base de datos o de versión de Spring, el dominio ni se entera.
- Separación radical con CQRS:
Dividimos las intenciones del sistema en dos carriles independientes:
- Commands: Modificaciones de estado (ej. actualizar estado de telemetría). Pasan por el dominio, ejecutan validaciones estrictas y emiten eventos.
- Queries: Consultas analíticas para paneles. Se saltan la carga del dominio y van directas a modelos de lectura optimizados para latencia mínima.
- Tooling interno con anotaciones personalizadas:
Escribir el cableado a mano para tantos microservicios generaba demasiado código repetitivo. Creamos nuestras propias anotaciones (
@CommandHandler,@QueryHandler,@UseCase) junto a un despachador interno que enrutaba los mensajes automáticamente.
3. El momento de la verdad: la trampa de JSONB
Para no rehacer las tablas con cada nuevo modelo, tomamos un atajo tentador: guardar el payload variable en una columna JSONB de PostgreSQL.
“Esquema dinámico y adiós a las migraciones”, pensamos. Fue el peor error del proyecto.
- Consultas convertidas en un infierno: En cuanto negocio necesitó filtros analíticos combinados, el SQL se llenó de operadores crípticos (
->>,#>>,jsonb_extract_path). Nadie quería tocar esas queries. - Índices GIN devoradores de recursos: Para que las búsquedas no colapsaran, tuvimos que crear múltiples índices GIN. Esos índices multiplicaron el tamaño en disco de las instancias de base de datos y ralentizaron las escrituras de forma dramática.
- La complejidad nunca desaparece, solo se traslada: Al quitar el esquema de la base de datos, toda la validación y retrocompatibilidad recayó en los adaptadores de Java, complicando el código mucho más de lo previsto.
Por lo que tomamos una decisión radical: tirar toda la implementación en JSONB y reconstruirla en RDBMS relacional. Por suerte esta decisión fue tomada en una etapa temprana del proyecto y no supuso los rompecabezas de hacer una migración de este estilo en producción con tráfico vivo.
4. Rigidez extrema vs. pragmatismo: la trampa de los 500 Value Objects
Cuando abrazas Domain-Driven Design (DDD) y la arquitectura hexagonal con fervor casi religioso, es fácil caer en la sobreingeniería. Y caímos de lleno.
En la teoría académica más pura, cualquier dato del negocio debe encapsularse en un Value Object inmutable con su propia validación. En la práctica real, esto se nos fue de las manos: acabamos creando cientos de clases que no eran más que un envoltorio artificial alrededor de un simple String, Integer o Boolean:
VehicleVinenvolviendo un String.EngineDisplacementenvolviendo un Integer.ExteriorColorenvolviendo un String.IsActiveenvolviendo un Boolean.
¿El resultado? Mover un dato sencillo desde un endpoint HTTP hasta la base de datos exigía desempaquetar, convertir, validar y volver a empaquetar decenas de primitivas a través de capas de mappers redundantes. Añadir un simple campo a una entidad requería editar hasta 10 archivos distintos. Nos ralentizaba una barbaridad en el día a día.
Lo que sí nos funcionó y recomendamos:
- Objetos Input y Output bien delimitados: Utilizar objetos específicos de entrada (Input DTOs) y salida (Output DTOs) para cruzar los puertos mantuvo los contratos limpios y desacoplados sin contaminar el dominio.
- Pragmatismo con las primitivas: Si un atributo no tiene reglas de negocio complejas ni invariantes que proteger, dejarlo como una primitiva o tipo estándar de Java dentro de la entidad es infinitamente más sano que mantener 500 clases sin valor real.
5. Resultados y aprendizajes
Tras completar la transición en la flota de microservicios y podar los excesos de sobreingeniería, el cambio operativo fue mayúsculo:
- Tests de dominio en milisegundos: La suite de tests unitarios del dominio pasó de ejecutarse en 20 minutos a menos de 30 segundos, permitiendo a los desarrolladores iterar sin fricción localmente sin necesidad de levantar Spring.
- Desacoplamiento real: Pudimos actualizar dependencias core y migrar adaptadores de mensajería sin tocar ni una sola línea de las reglas de negocio de Daimler.
Las grandes conclusiones que nos dejó este viaje:
- Huye del dogmatismo de los Value Objects: No todo necesita ser una clase separada si no encapsula lógica de negocio real. Los objetos Input/Output son la frontera ideal; envolver cada primitiva solo genera frustración en el equipo.
- JSONB no sustituye al modelado relacional: Si vas a necesitar filtrar o agregar datos con frecuencia, el atajo de la persistencia no estructurada se paga muy caro a medio plazo.
- CQRS compensa la inversión inicial: Crear tooling propio con anotaciones nos costó varias semanas de desarrollo, pero amortizamos esa inversión con creces al escalar a decenas de microservicios homogéneos.